Der er en ny AI i byen, og i modsætning til alt, der har domineret de seneste år, fører den ikke samtaler, skriver ikke prosa og har ingen holdninger. Den beslutter bare.
Jeg fik for nylig adgang til TypeSafe AI's Jev i early access og har testet den i vores egne produktionskritiske pipelines. I stedet for sætninger svarer Jev med typede valg og sandsynligheder: ja/nej, en score, et valg fra en fast liste. Ingen parsing, ingen hallucinerede afsnit, ingen personlighed.
Det lyder som en degradering, indtil man indser, hvor meget af det daglige infrastrukturarbejde, der aldrig var en samtale i første omgang. "Skal denne Ansible-ændring udrulles automatisk, eller skal et menneske se på den?" kræver ikke et essay tilbage. Det kræver en hurtig, kalibreret afgørelse.
Chatbot-mønstret er det forkerte værktøj til de fleste pipeline-beslutninger
De fleste af os har allerede løst den her opgave, bare med det forkerte værktøj: man beder en LLM om at "svare med JSON i dette format", parser resultatet og håber, den ikke pakker svaret ind i en forklaring eller en markdown-blok, man ikke bad om.
Det virker som regel. Men det er en samtalemodel presset ind i en rolle, den aldrig var bygget til: en funktion, ikke en dialogpartner. Man genererer ord, man ikke skal læse, for i sidste ende at trække tre bits information ud af dem: sikker, tvivlsom, farlig.
I vores plan/apply-workflow er det præcis det, der sker i det trin, hvor en AI-instans gennemgår en foreslået Ansible- eller Terraform-diff og vurderer, om den bør sendes videre til et menneske. Det er en klassifikation klædt ud som en samtale.
Hvad er en "System One"-model
Jev kalder sig selv en "System One"-model, med reference til KahnemansDaniel Kahneman er en israelsk-amerikansk psykolog og nobelprismodtager i økonomi (2002), for sit arbejde med adfærdsøkonomi sammen med Amos Tversky. Hans mest kendte bog er Thinking, Fast and Slow (2011), som beskriver to "systemer" i menneskelig tænkning:System 1: hurtig, automatisk, intuitiv, følelsesladet. Det er det, der genkender et ansigt på et splitsekund, eller straks "ved", at 2+2=4.System 2: langsom, bevidst, analytisk. Det er det, der regner et komplekst matematikstykke ud eller vejer et svært valg op imod hinanden. hurtige, intuitive tænkning frem for den langsomme, resonerende slags. Man sender ikke en prompt og venter på tekst. Man sender en tilstand (i vores tilfælde en diff) og et sæt typede spørgsmål på forhånd, og får typede svar tilbage med sandsynligheder på hver mulighed.
Forskellen fra at bede GPT eller Claude om at returnere JSON er strukturel, ikke stilistisk. Svaret er begrænset til de muligheder, man selv har defineret. Ingen JSON, der kan fejle parsing, ingen risiko for at modellen "glemmer" formatet halvvejs inde i et svar. Og fordi modellen evaluerer alle spørgsmål parallelt i stedet for at generere tekst token for token, er den markant hurtigere og billigere til den slags snævre, gentagne beslutninger, en pipeline stiller tusindvis af gange om dagen.
Det er en lille komponent, man sætter ind ét sted i en ellers almindelig kodebase, dér hvor koden har brug for én afgørelse.
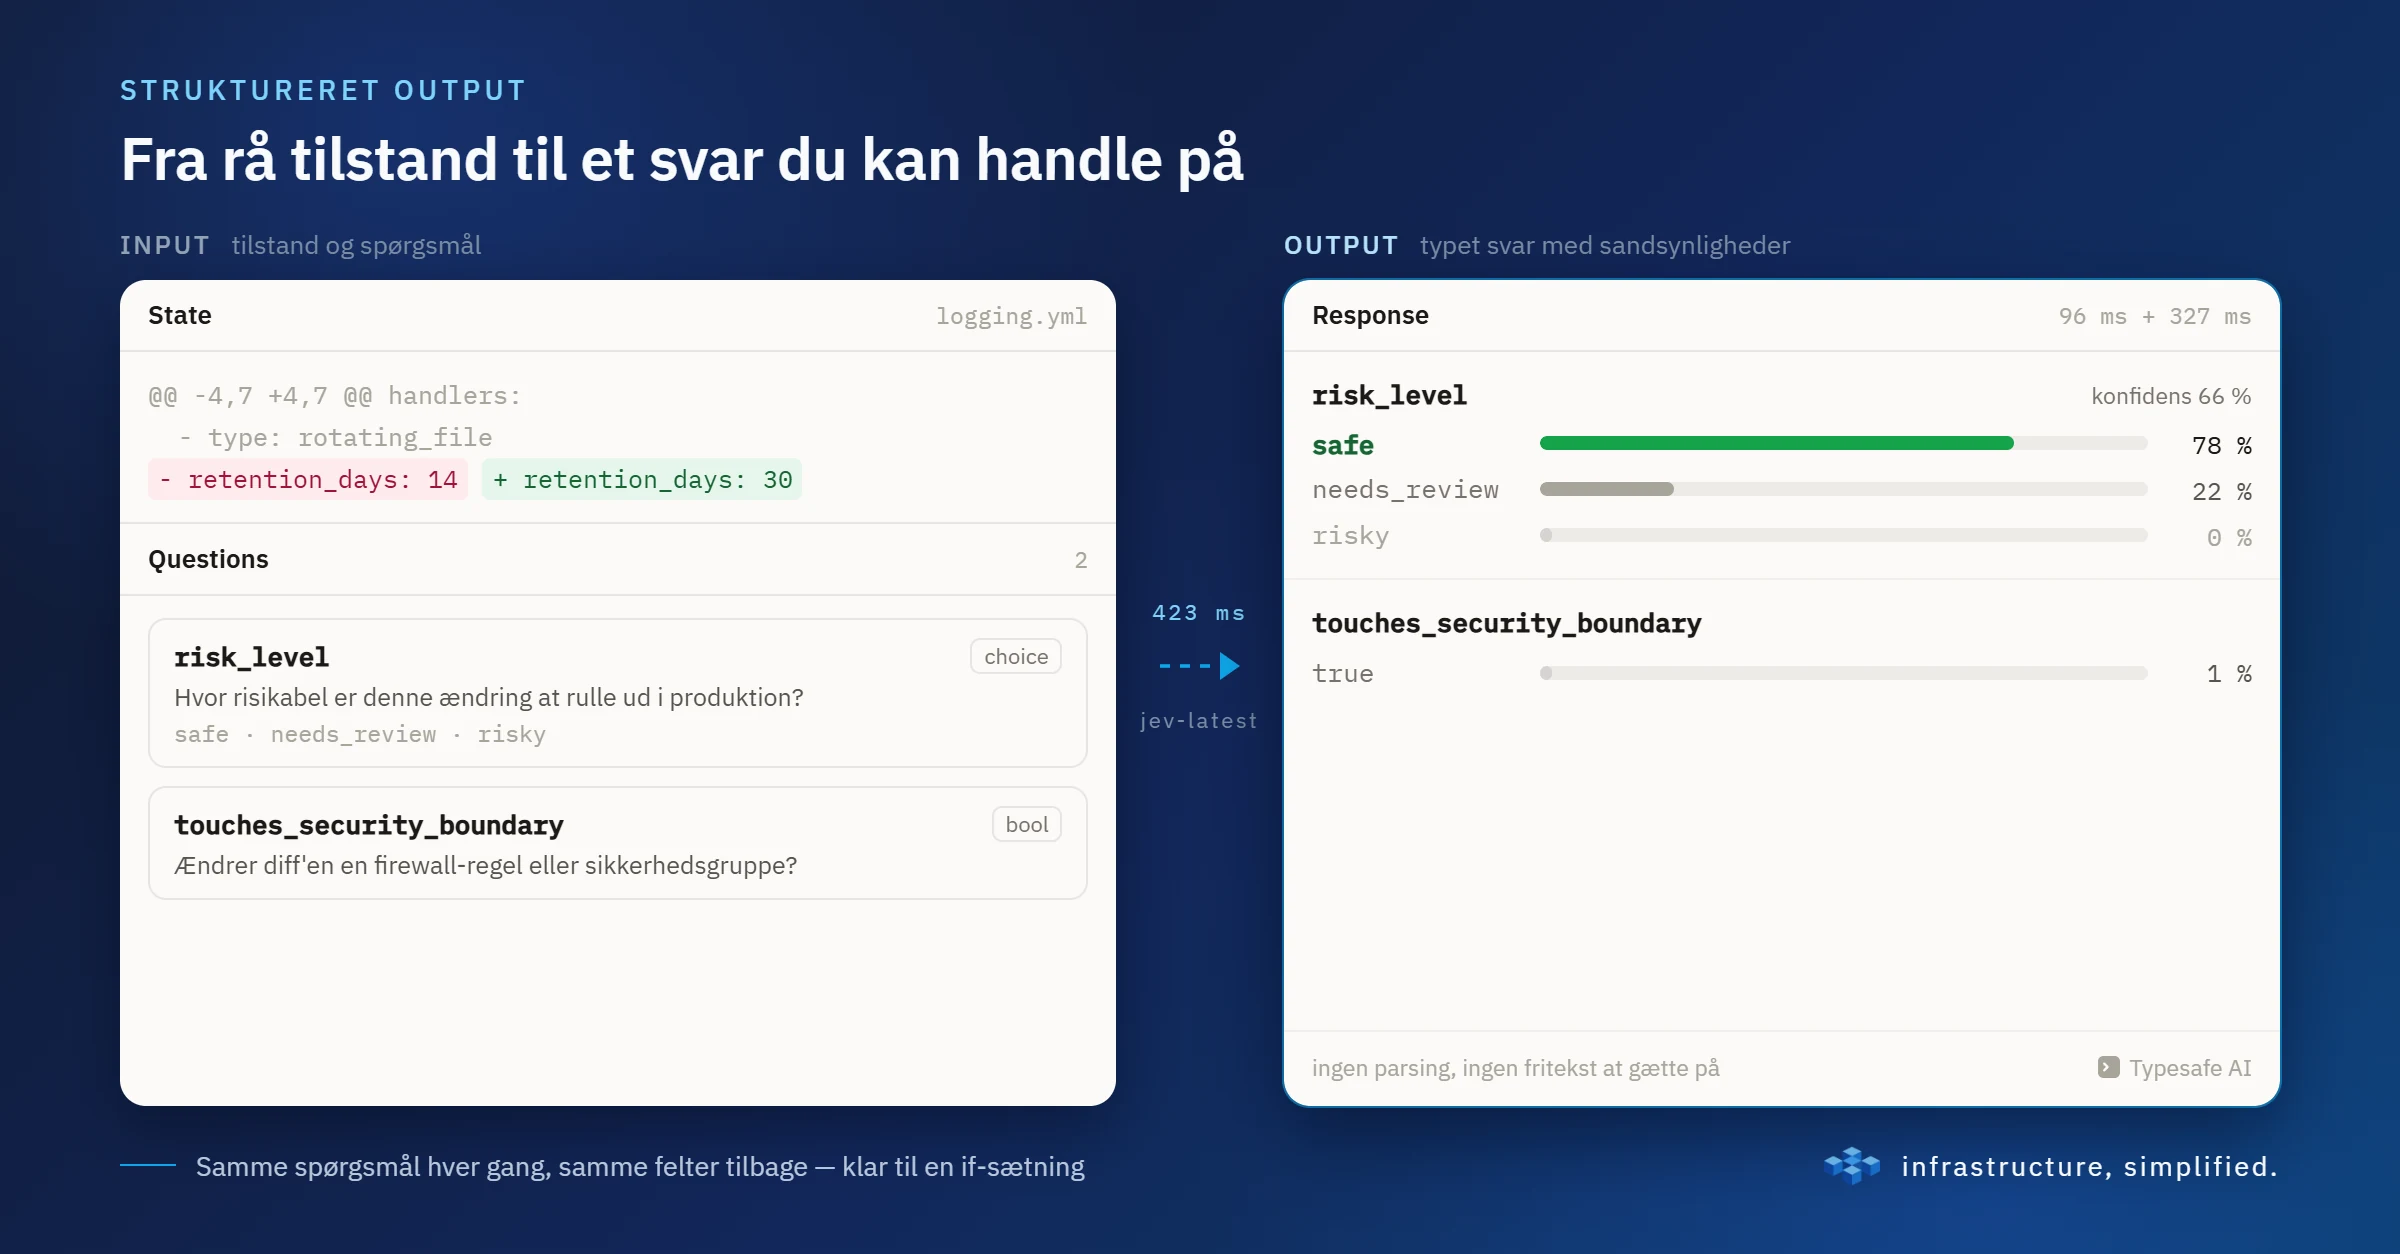
Her er, hvad vi rent faktisk sender, og hvad vi rent faktisk får tilbage, for den beslutning, jeg bruger i vores deploy-gate. Input, opdelt i to felter som i TypeSafes egen playground:
State (kun selve diffen):
{
  "state": "--- before: logging.yml\n+++ after: logging.yml\n@@ -4,7 +4,7 @@\n  handlers:\n  - type: rotating_file\n-    retention_days: 14\n+    retention_days: 30"
}
Questions (defineret på forhånd, uafhængigt af tilstanden):
{
  "risk_level": {
    "type": "choice",
    "instructions": "Hvor risikabel er denne ændring at rulle ud i produktion?",
    "criteria": {
      "safe": "Additiv eller lavrisiko-ændring",
      "needs_review": "Plausibel, men med reel blast radius",
      "risky": "Kan forårsage nedetid eller sikkerhedshul"
    }
  },
  "touches_security_boundary": {
    "type": "noul",
    "instructions": "Ændrer diff'en en firewall-regel eller sikkerhedsgruppe?"
  }
}
Output (faktisk svar fra vores kørsel i playground):
{
  "model": "jev-1.13.0",
  "answers": {
    "risk_level": {
      "type": "choice",
      "choice": "safe",
      "confidence": 0.66,
      "probabilities": { "risky": 0, "needs_review": 0.22, "safe": 0.78 },
      "stats": {}
    },
    "touches_security_boundary": { "type": "noul", "noul": 0.01, "stats": {} }
  },
  "usage": { "input_tokens": 441, "output_tokens": 62 },
  "request_id": "playground_1e9560b8a94c95743b684bfe47c032eb660",
  "evaluation_time_ms": 96.33424999992712
}
answers.risk_level.choice er enten "safe", "needs_review" eller "risky", intet andet, fordi det er præcis de tre nøgler, vi selv definerede under criteria i Questions-blokken ovenfor. Jev opfinder ikke selv mulighederne. Den vælger mellem dem, vi allerede har fastlagt, og koden kan derfor branche direkte på værdien, uden at skulle håndtere et fjerde, uventet svar. Sammenlign det med en almindelig LLM, hvor man selv skal skrive parsing-kode til at redde situationen, når modellen alligevel pakker svaret ind i en forklaring.
Én præcisering: dette JSON-format er TypeSafes eget, en kontrakt for deres API, ikke en åben standard. Det er et andet niveau end MCP, som jeg har skrevet om tidligere, hvor pointen netop er leverandøruafhængighed. Jevs format løser et andet problem (typede afgørelser frem for tekst), og de to konkurrerer ikke; en Jev-vurdering kunne sagtens sidde bag et MCP-tool-kald som selve beslutningslogikken.
Sådan har jeg genopbygget vores Ansible-deploy-gate omkring Jev
Jeg tog vores eksisterende AI-review-trin og byggede en parallel version omkring Jev, for at se om samme trin kunne klares hurtigere og billigere uden at gå på kompromis med kvaliteten af afgørelsen.
Opsætningen: hver diff sendes som tilstand sammen med to spørgsmål: et valg mellem "sikker", "kræver review" og "risikabel", og et ja/nej om, hvorvidt ændringen rører en firewall-regel eller sikkerhedsgruppe. Jev svarer med et valg og en sandsynlighed for hver mulighed, ikke bare en etiket.
Jeg kørte samme klassifikation gennem begge veje, Jev og vores nuværende LLM-baserede gate, på et sæt eksempeldiffs og målte svartid og pris. Forskellen i hastighed er markant, i den størrelsesorden TypeSafe selv reklamerer med. Det interessante er ikke selve tallet, men at en snæver beslutning nu koster en brøkdel af, hvad den gjorde, når man ikke længere betaler for prosa, man kasserer alligevel.
Værd at være tydelig om: TypeSafe rapporterer selv 70-500ms end-to-end og store hastigheds- og prisfordele i deres egne workflow-evalueringer, tal, der ifølge dem selv formentlig ligger i den optimistiske ende af, hvad man kan forvente i praksis. Det er leverandørens egne tal, så jeg bruger dem ikke som facit. Vores egen baseline er en direkte JSON-klassifikation uden ræsonnering, og det er den sammenligning, jeg reelt er interesseret i.
"70ms versus flere sekunder" er ikke æbler mod æbler, hvis LLM-baseline'n laver fuld chain-of-thought undervejs. Mange demoer sammenligner Jev mod en model, der ræsonnerer sig frem gennem flere trin. Vores egen baseline gør ikke det: den bliver bedt om at svare direkte med JSON, samme opgave, samme format, ingen ræsonnering undervejs. Så forskellen, vi måler, er en fair sammenligning frem for marketing.
Hvorfor jeg kører det i shadow mode først
Jeg har ikke givet Jev nøglerne til noget som helst endnu.
Modellen har været offentligt tilgængelig i knap en uge. At give en model uden track record adgang til en produktions-apply-knap er sådan, man ender i en incident-rapport.
I stedet kører Jev i shadow mode: den evaluerer hver diff parallelt med vores eksisterende gate, men dens svar bliver logget, ikke handlet på. Over de kommende uger sammenligner jeg dens vurderinger med, hvad der faktisk skete (blev planen godkendt, blev den afvist, gik noget galt) før jeg overvejer at lade den få indflydelse på selve beslutningen. Det er samme disciplin, resten af vores workflow allerede er bygget på: en ny komponent bevæger sig aldrig direkte til produktion, men gennem et trin, hvor nogen kan se, hvad den ville have gjort, før den får lov til rent faktisk at gøre det.
Hvor jeg stadig insisterer på et menneske, uanset hvad konfidenstallet siger
Selv når Jev en dag flytter fra shadow mode til at have reel indflydelse, ændrer det ikke ved reglen: AI'en foreslår aldrig direkte handling. Den foreslår en vurdering af en diff, og den vurdering bliver stadig læst af et menneske, før noget rammer produktion, uanset om vurderingen kommer fra en samtalemodel, der har brugt flere sætninger på at tænke sig om, eller en model, der svarede med 85% sandsynlighed på 100 millisekunder.
Høj konfidens er ikke det samme som fuld kontekst. Jev kan formentlig hurtigt og præcist vurdere, om en diff ligner noget, der plejer at være sikkert. Den har ikke fornemmelsen for, hvorfor tingene ser ud, som de gør hos os specifikt, eller hvilke skjulte afhængigheder der findes mellem vores systemer. En hurtig, kalibreret model gør beslutningen billigere at stille. Den gør den ikke til den sidste.
TypeSafe reklamerer med "zero hallucination", og det er rigtigt i en snæver forstand: Jev finder ikke på et svar uden for de muligheder, man selv definerede. Men en kalibreret model er ikke det samme som en ufejlbarlig model. Hvis en model på en given population er kalibreret sådan, at dens 95%-niveau faktisk svarer til cirka 95% korrekte afgørelser, vil omkring 5% stadig være forkerte, og modellen rækker ikke selv hånden op ved dem, den var jo netop 95% sikker ifølge sin egen kalibrering. Et sikkert, forkert svar er fuldt foreneligt med god kalibrering. Det gælder enhver model, der returnerer en sandsynlighed, og det er præcis derfor, konfidenstallet aldrig bør stå alene som beslutning. Det er et signal, ikke en garanti.
Det er interessant, at Digitaliseringsstyrelsens aktuelle lovforslag om offentlige myndigheders brug af AI ligefrem definerer "beslutningsstøtte" som AI-genererede forslag eller anbefalinger, som en fysisk person inddrager i den samlede faglige vurdering, uden at AI-systemet selv træffer afgørelsen eller iværksætter tiltaget. Lovforslaget giver samtidig ikke hjemmel til fuldautomatiske afgørelser efter GDPR artikel 22. Det er, lovteknisk set, præcis den samme skelnen, jeg forsøger at holde fast i her: en model, uanset hvor kalibreret den er, leverer et forslag til en beslutning, den træffer den ikke selv.
I vores konkrete eksempel giver Jev "safe" en sandsynlighed på 78%, mens svaret samtidig har en confidence-værdi på 66%. De to tal er ikke det samme, TypeSafe beskriver confidence som et kalibreret mål, hvor højere konfidens svarer til højere nøjagtighed, men det er ikke nødvendigvis identisk med "der er 66% chance for, at svaret er korrekt." Jeg vil ikke bruge nogen af de to tal som en direkte garanti for korrekthed, kun som et signal om, hvornår et menneske skal ind, og hvornår det ikke er nødvendigt at bruge deres tid. En model som Jev afgør dermed ikke, om mennesket fjernes fra beslutningen, men hvornår mennesket rent faktisk skal involveres, og hvornår det bare er støj.
Et seriøst bud på AI, der taler med software
Chatbot-æraen gjorde AI god til at tale med mennesker. Det her er noget andet: et seriøst bud på en model, der primært taler med software, ikke med os. Infrastrukturautomatisering er måske netop der, det betaler sig først, ikke fordi beslutningerne er vigtigere end dem, en chatbot træffer, men fordi der er så forbandet mange af dem, og hver enkelt er så lille, at det aldrig gav mening at betale for et essay for at få et ja eller nej.
Jeg opdaterer, når shadow mode-dataene begynder at sige noget. Indtil da: hvis I selv sidder med en pipeline fuld af snævre, gentagne beslutninger klædt ud som chat-kald, er det måske værd at spørge, om det overhovedet var en samtale, I havde brug for.