Es gibt eine neue KI in der Stadt, und anders als alles, was die letzten Jahre dominiert hat, führt sie keine Gespräche, schreibt keine Prosa und hat keine Meinungen. Sie entscheidet einfach.
Ich habe kürzlich Early-Access-Zugang zu Jev von TypeSafe AI bekommen und sie in unseren eigenen produktionskritischen Pipelines getestet. Statt Sätzen antwortet Jev mit typisierten Entscheidungen und Wahrscheinlichkeiten: Ja/Nein, ein Score, eine Auswahl aus einer festen Liste. Kein Parsing, keine halluzinierten Absätze, keine Persönlichkeit.
Das klingt nach einem Rückschritt, bis man merkt, wie viel der täglichen Infrastrukturarbeit nie ein Gespräch war. „Soll diese Ansible-Änderung automatisch ausgerollt werden, oder soll ein Mensch sie ansehen?" braucht keinen Essay als Antwort. Sie braucht ein schnelles, kalibriertes Urteil.
Das Chatbot-Muster ist für die meisten Pipeline-Entscheidungen das falsche Werkzeug
Die meisten von uns haben diese Aufgabe schon gelöst, nur mit dem falschen Werkzeug: Man bittet ein LLM, „mit JSON in diesem Format zu antworten", parst das Ergebnis und hofft, dass es die Antwort nicht in eine Erklärung oder einen Markdown-Block verpackt, um den man nicht gebeten hat.
Meistens funktioniert das. Aber es ist ein Gesprächsmodell, das in eine Rolle gepresst wird, für die es nie gebaut wurde: eine Funktion, kein Dialogpartner. Man erzeugt Wörter, die man nicht lesen will, um am Ende drei Bit Information herauszuziehen: sicher, zweifelhaft, gefährlich.
In unserem Plan/Apply-Workflow passiert genau das in dem Schritt, in dem eine KI-Instanz einen vorgeschlagenen Ansible- oder Terraform-Diff prüft und beurteilt, ob er an einen Menschen weitergeleitet werden sollte. Es ist eine Klassifikation im Gewand eines Gesprächs.
Was ein „System One"-Modell ist
Jev bezeichnet sich selbst als „System One"-Modell, in Anlehnung an KahnemansDaniel Kahneman ist ein israelisch-amerikanischer Psychologe und Wirtschaftsnobelpreisträger (2002), ausgezeichnet für seine Arbeit zur Verhaltensökonomie gemeinsam mit Amos Tversky. Sein bekanntestes Buch ist Schnelles Denken, langsames Denken (Thinking, Fast and Slow, 2011), das zwei „Systeme" des menschlichen Denkens beschreibt:System 1: schnell, automatisch, intuitiv, gefühlsgeladen. Es erkennt ein Gesicht in einem Sekundenbruchteil oder „weiß" sofort, dass 2+2=4 ist.System 2: langsam, bewusst, analytisch. Es löst eine komplexe Rechenaufgabe oder wägt eine schwierige Entscheidung gegeneinander ab. schnelles, intuitives Denken im Gegensatz zum langsamen, abwägenden. Man schickt keinen Prompt und wartet auf Text. Man schickt einen Zustand (bei uns einen Diff) und vorab einen Satz typisierter Fragen und bekommt typisierte Antworten zurück, mit Wahrscheinlichkeiten für jede Option.
Der Unterschied dazu, GPT oder Claude JSON zurückgeben zu lassen, ist strukturell, nicht stilistisch. Die Antwort ist auf die Optionen beschränkt, die man selbst definiert hat. Es gibt kein JSON, das beim Parsen scheitern kann, und keine Gefahr, dass das Modell das Format mitten in der Antwort „vergisst". Und weil das Modell alle Fragen parallel auswertet, statt Text Token für Token zu erzeugen, ist es bei genau den engen, wiederkehrenden Entscheidungen, die eine Pipeline tausendfach am Tag stellt, deutlich schneller und günstiger.
Es ist eine kleine Komponente, die man an einer Stelle in eine ansonsten gewöhnliche Codebasis einsetzt, dort, wo der Code ein einzelnes Urteil braucht.
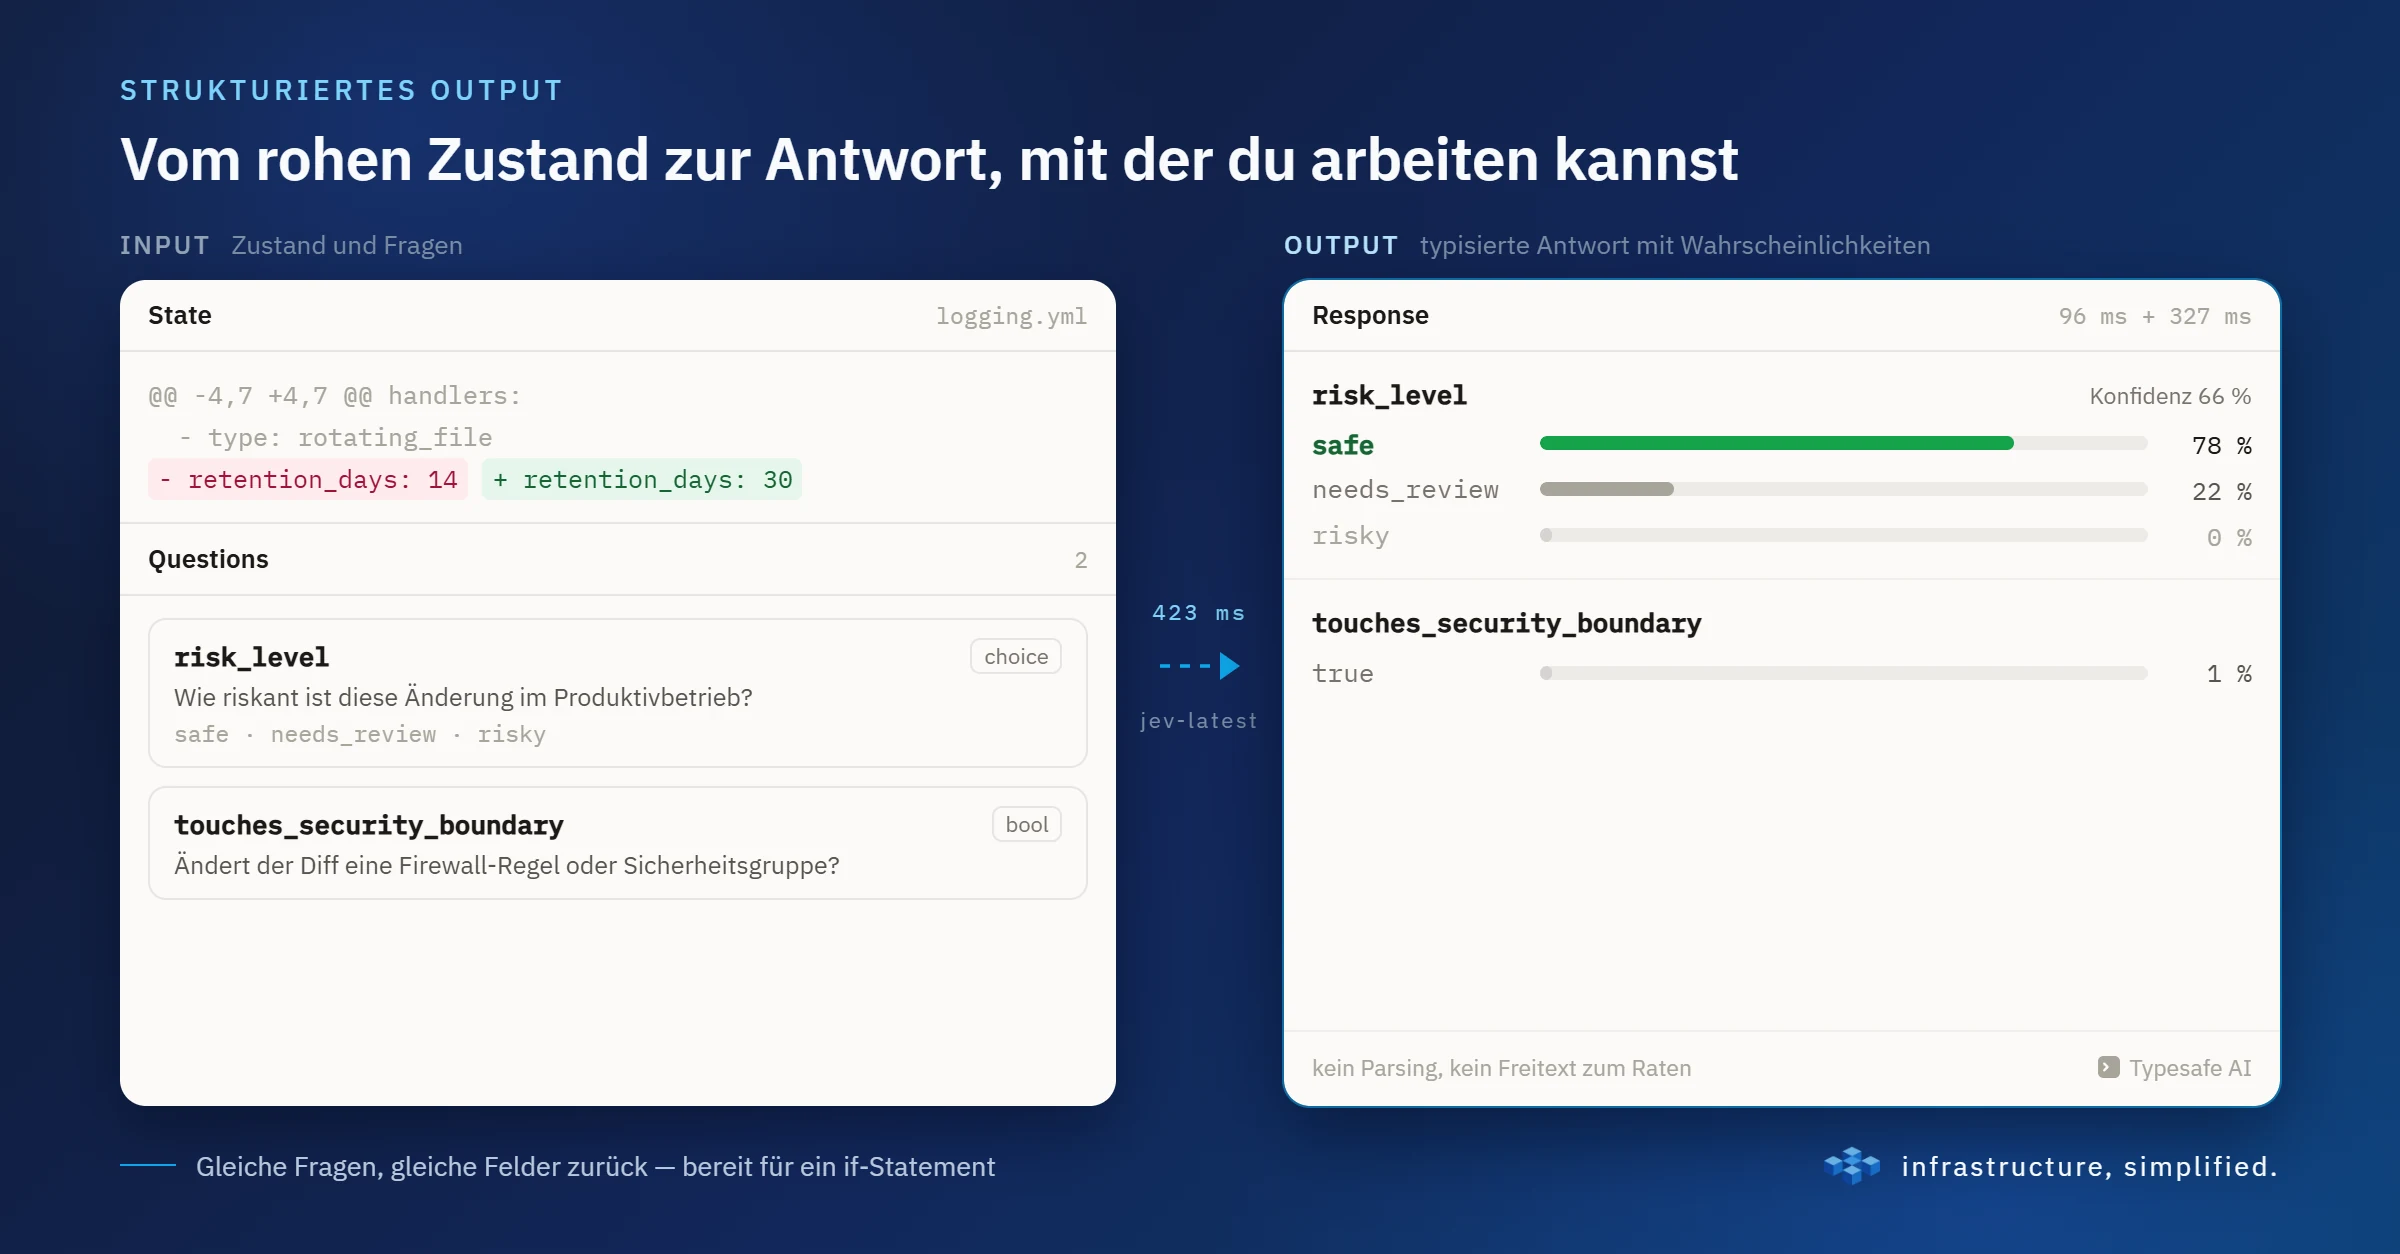
Das schicken wir tatsächlich, und das bekommen wir tatsächlich zurück, für die Entscheidung, die ich in unserem Deploy-Gate nutze. Die Eingabe ist wie in TypeSafes eigenem Playground in zwei Felder aufgeteilt:
State (nur der Diff selbst):
{
  "state": "--- before: logging.yml\n+++ after: logging.yml\n@@ -4,7 +4,7 @@\n  handlers:\n  - type: rotating_file\n-    retention_days: 14\n+    retention_days: 30"
}
Questions (vorab definiert, unabhängig vom Zustand):
{
  "risk_level": {
    "type": "choice",
    "instructions": "Wie riskant ist diese Änderung im Produktivbetrieb?",
    "criteria": {
      "safe": "Additive oder risikoarme Änderung",
      "needs_review": "Plausibel, aber mit realem Wirkungsradius",
      "risky": "Kann Ausfälle oder Sicherheitslücken verursachen"
    }
  },
  "touches_security_boundary": {
    "type": "noul",
    "instructions": "Ändert der Diff eine Firewall-Regel oder Sicherheitsgruppe?"
  }
}
Output (die tatsächliche Antwort aus unserem Lauf im Playground):
{
  "model": "jev-1.13.0",
  "answers": {
    "risk_level": {
      "type": "choice",
      "choice": "safe",
      "confidence": 0.66,
      "probabilities": { "risky": 0, "needs_review": 0.22, "safe": 0.78 },
      "stats": {}
    },
    "touches_security_boundary": { "type": "noul", "noul": 0.01, "stats": {} }
  },
  "usage": { "input_tokens": 441, "output_tokens": 62 },
  "request_id": "playground_1e9560b8a94c95743b684bfe47c032eb660",
  "evaluation_time_ms": 96.33424999992712
}
answers.risk_level.choice ist entweder „safe", „needs_review" oder „risky", nichts anderes, denn das sind genau die drei Schlüssel, die wir selbst oben im Questions-Block unter criteria definiert haben. Jev erfindet die Optionen nicht selbst. Es wählt zwischen denen, die wir bereits festgelegt haben, und der Code kann deshalb direkt auf den Wert verzweigen, ohne eine vierte, unerwartete Antwort behandeln zu müssen. Vergleichen Sie das mit einem gewöhnlichen LLM, bei dem man eigenen Parsing-Code schreiben muss, um die Lage zu retten, wenn das Modell die Antwort trotzdem in eine Erklärung verpackt.
Eine Klarstellung: Dieses JSON-Format ist TypeSafes eigenes, ein Vertrag für ihre API, kein offener Standard. Es liegt auf einer anderen Ebene als MCP, über das ich schon geschrieben habe und bei dem es gerade um Anbieterunabhängigkeit geht. Jevs Format löst ein anderes Problem (typisierte Entscheidungen statt Text), und die beiden konkurrieren nicht; eine Jev-Bewertung könnte durchaus hinter einem MCP-Tool-Aufruf als eigentliche Entscheidungslogik sitzen.
So habe ich unser Ansible-Deploy-Gate um Jev herum neu gebaut
Ich habe unseren bestehenden KI-Review-Schritt genommen und eine parallele Version um Jev herum gebaut, um zu sehen, ob derselbe Schritt schneller und günstiger zu erledigen ist, ohne die Qualität des Urteils zu opfern.
Der Aufbau: Jeder Diff wird als Zustand zusammen mit zwei Fragen gesendet, einer Wahl zwischen „sicher", „Review erforderlich" und „riskant" sowie einem Ja/Nein dazu, ob die Änderung eine Firewall-Regel oder eine Sicherheitsgruppe berührt. Jev antwortet mit einer Wahl und einer Wahrscheinlichkeit für jede Option, nicht nur mit einem Etikett.
Ich habe dieselbe Klassifikation über beide Wege laufen lassen, Jev und unser aktuelles LLM-basiertes Gate, auf einer Reihe von Beispiel-Diffs und Antwortzeit und Preis gemessen. Der Geschwindigkeitsunterschied ist deutlich, in der Größenordnung, die TypeSafe selbst bewirbt. Interessant ist nicht die Zahl selbst, sondern dass eine enge Entscheidung nur noch einen Bruchteil kostet, wenn man nicht mehr für Prosa bezahlt, die man ohnehin verwirft.
Wichtig ist mir, hier klar zu sein: TypeSafe selbst nennt 70-500 ms Ende-zu-Ende und große Geschwindigkeits- und Preisvorteile in den eigenen Workflow-Evaluierungen, Zahlen, die nach eigener Aussage wahrscheinlich am optimistischen Ende dessen liegen, was man in der Praxis erwarten kann. Das sind die eigenen Zahlen des Anbieters, deshalb nutze ich sie nicht als Maßstab. Unsere eigene Baseline ist eine direkte JSON-Klassifikation ohne Reasoning, und das ist der Vergleich, der mich tatsächlich interessiert.
„70 ms gegen mehrere Sekunden" ist kein fairer Vergleich, wenn die LLM-Baseline unterwegs eine vollständige Chain-of-Thought durchläuft. Viele Demos vergleichen Jev mit einem Modell, das sich über mehrere Schritte zur Antwort denkt. Unsere eigene Baseline tut das nicht: Sie wird gebeten, direkt mit JSON zu antworten, gleiche Aufgabe, gleiches Format, kein Reasoning unterwegs. Der Unterschied, den wir messen, ist also ein fairer Vergleich statt Marketing.
Warum ich es zuerst im Shadow Mode betreibe
Ich habe Jev noch keine Schlüssel zu irgendetwas gegeben.
Das Modell ist erst seit knapp einer Woche öffentlich verfügbar. Einem Modell ohne Erfolgsbilanz Zugriff auf einen Produktions-Apply-Knopf zu geben, ist der Weg in einen Incident-Bericht.
Stattdessen läuft Jev im Shadow Mode: Es bewertet jeden Diff parallel zu unserem bestehenden Gate, aber seine Antworten werden protokolliert und nicht umgesetzt. In den kommenden Wochen vergleiche ich seine Bewertungen mit dem, was tatsächlich passiert ist (wurde der Plan freigegeben, wurde er abgelehnt, ist etwas schiefgegangen), bevor ich überlege, ihm Einfluss auf die Entscheidung selbst zu geben. Es ist dieselbe Disziplin, auf der der Rest unseres Workflows ohnehin aufgebaut ist: Eine neue Komponente geht nie direkt in Produktion, sondern durch einen Schritt, in dem jemand sehen kann, was sie getan hätte, bevor sie es wirklich tun darf.
Wo ich weiterhin auf einem Menschen bestehe, egal was die Konfidenzzahl sagt
Selbst wenn Jev eines Tages vom Shadow Mode zu echtem Einfluss wechselt, ändert das nichts an der Regel: Die KI schlägt nie direkt eine Handlung vor. Sie schlägt eine Bewertung eines Diffs vor, und diese Bewertung wird weiterhin von einem Menschen gelesen, bevor etwas in Produktion geht, egal ob die Bewertung von einem Gesprächsmodell stammt, das mehrere Sätze lang nachgedacht hat, oder von einem Modell, das in 100 Millisekunden mit 85 % Wahrscheinlichkeit geantwortet hat.
Hohe Konfidenz ist nicht dasselbe wie voller Kontext. Jev kann vermutlich schnell und präzise beurteilen, ob ein Diff nach etwas aussieht, das normalerweise sicher ist. Es hat kein Gefühl dafür, warum die Dinge bei uns so aussehen, wie sie aussehen, oder welche versteckten Abhängigkeiten zwischen unseren Systemen bestehen. Ein schnelles, kalibriertes Modell macht die Entscheidung günstiger zu stellen. Es macht sie nicht zur letzten.
TypeSafe wirbt mit „zero hallucination", und das stimmt in einem engen Sinn: Jev erfindet keine Antwort außerhalb der Optionen, die man selbst definiert hat. Aber ein kalibriertes Modell ist nicht dasselbe wie ein unfehlbares. Wenn ein Modell auf einer gegebenen Population so kalibriert ist, dass sein 95-%-Niveau ungefähr 95 % richtigen Urteilen entspricht, sind trotzdem etwa 5 % falsch, und das Modell hebt bei diesen nicht die Hand, denn es war nach eigener Kalibrierung ja gerade zu 95 % sicher. Eine sichere, falsche Antwort ist vollkommen vereinbar mit guter Kalibrierung. Das gilt für jedes Modell, das eine Wahrscheinlichkeit zurückgibt, und genau deshalb sollte die Konfidenzzahl nie allein als Entscheidung stehen. Sie ist ein Signal, keine Garantie.
Interessant ist, dass der aktuelle Gesetzentwurf der dänischen Digitalisierungsbehörde zur KI-Nutzung öffentlicher Stellen „Entscheidungsunterstützung" ausdrücklich als KI-generierte Vorschläge oder Empfehlungen definiert, die eine natürliche Person in die fachliche Gesamtbewertung einbezieht, ohne dass das KI-System selbst die Entscheidung trifft oder die Maßnahme einleitet. Der Entwurf schafft gleichzeitig keine Grundlage für vollautomatisierte Entscheidungen nach Artikel 22 DSGVO. Das ist, rechtstechnisch gesehen, genau dieselbe Unterscheidung, die ich hier festzuhalten versuche: Ein Modell, wie gut kalibriert es auch sein mag, liefert einen Entscheidungsvorschlag, es trifft die Entscheidung nicht selbst.
In unserem konkreten Beispiel gibt Jev „safe" eine Wahrscheinlichkeit von 78 %, während die Antwort gleichzeitig einen Confidence-Wert von 66 % hat. Die beiden Zahlen sind nicht dasselbe. TypeSafe beschreibt Confidence als kalibriertes Maß, bei dem höhere Konfidenz höherer Genauigkeit entspricht, aber es ist nicht zwingend identisch mit „mit 66 % Wahrscheinlichkeit ist die Antwort richtig". Ich werde keine der beiden Zahlen als direkte Garantie für Korrektheit verwenden, nur als Signal dafür, wann ein Mensch eingreifen muss und wann es nicht nötig ist, dessen Zeit zu beanspruchen. Ein Modell wie Jev entscheidet also nicht, ob der Mensch aus der Entscheidung entfernt wird, sondern wann der Mensch tatsächlich einbezogen werden muss und wann es nur Rauschen ist.
Ein ernsthafter Versuch einer KI, die mit Software spricht
Die Chatbot-Ära hat KI gut darin gemacht, mit Menschen zu sprechen. Das hier ist etwas anderes: ein ernsthafter Versuch eines Modells, das hauptsächlich mit Software spricht, nicht mit uns. Infrastrukturautomatisierung ist vielleicht genau der Ort, an dem es sich zuerst auszahlt, nicht weil die Entscheidungen wichtiger wären als die, die ein Chatbot trifft, sondern weil es so verdammt viele davon gibt und jede einzelne so klein ist, dass es nie sinnvoll war, für einen Essay zu bezahlen, um ein Ja oder Nein zu bekommen.
Ich melde mich wieder, wenn die Shadow-Mode-Daten anfangen, etwas auszusagen. Bis dahin: Wenn Sie selbst eine Pipeline voller enger, wiederkehrender Entscheidungen haben, die als Chat-Aufrufe verkleidet sind, lohnt sich vielleicht die Frage, ob es überhaupt ein Gespräch war, das Sie gebraucht haben.